Un cachorro llamado Hugo
8 de octubre de 2026. Estaba viendo Data Hero Summit 2026, el evento virtual de Profisee, desde mi escritorio en Costa Rica. No vendo Profisee y no tengo ninguna relación con la empresa. Malcolm Hawker, su Chief Data Officer, dio el keynote: What Is Trust Made Of (¿de qué está hecha la confianza?). Él trabaja con algunas de las empresas más grandes del mundo. Yo trabajo con empresas medianas en Centroamérica. Nunca nos hemos conocido, y estaba describiendo las plataformas de datos que veo todas las semanas.
El audio falló los primeros minutos, así que lo que tengo de la apertura es una captura de pantalla. Un cachorro estilo cómic, un terrier blanco y negro de ojos grandes, con un globo de diálogo: “Tu nuevo agente de AI. Sabe mucho de muchas cosas. ¿De tu negocio? Prácticamente nada.” Se llama Hugo. (Hugo también es un acrónimo en el slide: Harmonize, Unify, Govern, Orchestrate. Esa es la parte del proveedor, y ahí la dejo.)
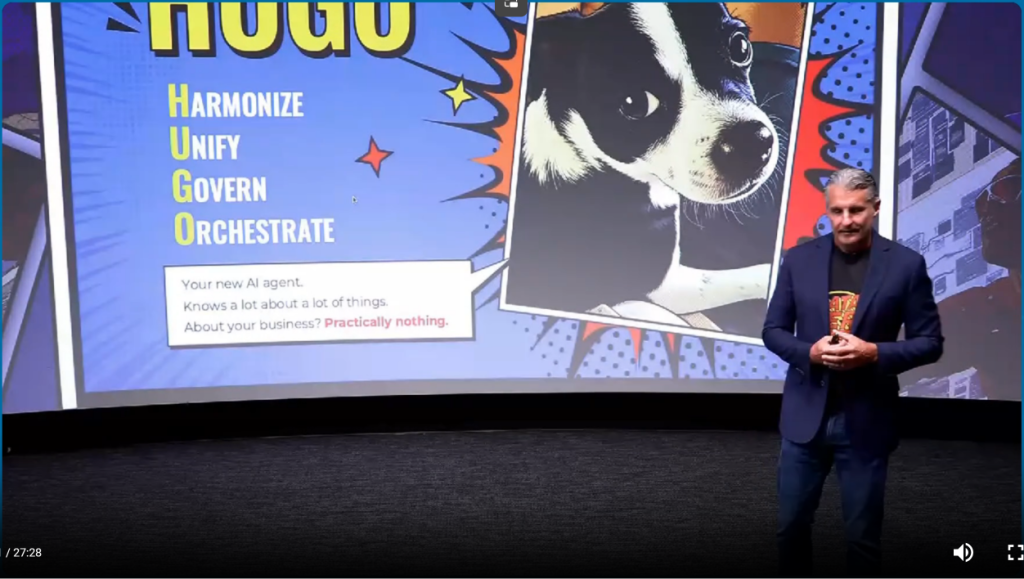
Slide del keynote de Malcolm Hawker, What Is Trust Made Of, Data Hero Summit 2026 (Profisee).
No necesité el audio. Hugo no tiene los pies en la tierra. Te va a traer algo cada vez que le tirés la bola, con entusiasmo total, y no tiene forma de saber si lo que trajo era la bola.
Unos slides después volvió el sonido, y con él, el trabajo de Hugo: “Las respuestas se veían perfectas. Y estaban equivocadas, en silencio y con total seguridad.”
Sonreí. Una semana antes yo había cerrado una serie sobre esa misma idea, sin el perro. Nadie le copió a nadie. Cuando alguien que mira corporaciones globales y alguien que mira a un distribuidor en Costa Rica describen la misma falla por su cuenta, deja de ser una opinión. Es como funcionan hoy las plataformas de datos modernas.
El arreglo que propuse
Trust Erosion terminó el 1 de octubre. Diez posts desarmando números que mentían: una definición que todos firmaron y nadie compartía, una tabla que dejó de coincidir con su concepto, una suma de cosas que no se podían sumar, una métrica manipulada para cobrar un bono. Cerré la serie con una frase, y la sigo creyendo: el arreglo nunca fue un mejor número. Fue un mejor lector. Los ingenieros que interrogaron al sensor antes de creerle. El analista que pregunta de dónde sale lo que muestra el dashboard.
Hugo no hace preguntas. Un agente no tiene criterio propio. No siente esa pequeña incomodidad que sentís vos cuando un número es demasiado redondo, y no puede darse cuenta de que una lectura le debería molestar. Lee etiquetas y va a traer.
Entonces mi arreglo tiene un problema. El lector cambió.
Hawker lo dijo mejor de lo que lo hubiera dicho yo: “La AI no creó este problema. La AI lo está amplificando.” Yo llevo años diciendo lo mismo desde el otro extremo: cada ola tecnológica nos da una nueva oportunidad de repetir los mismos errores de siempre. Esta ola los repite más rápido, a escala y con formato perfecto.
Por qué importa la fuente
El centro del keynote fue un artículo que Anthropic publicó el 3 de junio: How Anthropic Enables Self-Service Data Analytics with Claude. Cuenta cómo lograron que sus propios agentes de analítica fueran confiables. El punto de Hawker era quién lo escribió. No una consultora que vende gobierno de datos, no un proveedor de MDM: la empresa que construye el modelo, tratando de que sus propios agentes dejen de dar respuestas equivocadas. ¿Y adónde llegaron? A los fundamentos de datos. Ya somos dos, desde puntos de vista muy distintos, y un tercero desde adentro del modelo.
También es un artículo de producto. Está en el sitio de Anthropic, en la categoría de Claude Code, y el salto que reporta viene de una funcionalidad que venden. Pero fijate qué hace esa funcionalidad. Los skills no hacen más inteligente al modelo: le dicen qué tablas son las canónicas, quién es dueño de cada definición y qué leer primero. Sin ellos, su propio modelo nunca pasó del 21% en sus pruebas. Con ellos, se mantiene arriba del 95%. Que un fabricante de modelos te diga que el modelo solo no alcanza vale más que si te lo dice un proveedor de datos.
Dos transparencias antes de recomendarlo. Soy consultor y me gano la vida con los fundamentos de datos, y escribo estos posts con Claude. Descontá lo que corresponda. Aun así: si trabajás con datos y AI generativa, este artículo es lectura obligatoria. No es nuevo. Es el reporte de campo más claro que he visto sobre lo que un agente necesita antes de que le podás creer.
Lo que encontraron
Nombran tres fallas. La primera, que llaman “por mucho la más común”, es que el agente no logra asociar un concepto de negocio con la única tabla correcta. La segunda es la desactualización: las fuentes, las definiciones y los esquemas cambian, y lo que sabe el agente se queda atrás sin que nadie lo note. La tercera es de búsqueda: la respuesta correcta está en el modelo, documentada, y el agente no la encuentra.
El hallazgo al que siempre vuelvo es un experimento. Le dieron al agente acceso con grep a miles de archivos SQL (dashboards, transformaciones, notebooks de analistas), todo el trabajo previo que tenían. La precisión se movió menos de un punto. Su conclusión: “nuestro cuello de botella no era el acceso al trabajo previo, era la estructura”.
Más acceso no ayudó. Ponerle nombre a las cosas, sí.
También prueban como ingenieros: pruebas fijadas a una fecha de corte para que la respuesta no se les mueva, y ningún dominio sale a producción hasta que su agente pase un umbral (arrancaron con alrededor de 90%). Eso es calidad de datos con otro nombre. Merece su propio post, y lo dejo fuera de este.
La misma pila, en nuestro vocabulario
Esta es la parte que vieron los expositores y en la que coincido: casi nada del artículo es nuevo para la gestión de datos. Solo que no usa nuestras palabras. Abajo está el mapa. La tercera columna es donde lo escribí desde el lado humano, en Trust Erosion. La cuarta es donde lo voy a escribir desde el lado del agente, en la serie que arranca la semana que viene.
| Cómo lo llama Anthropic | Cómo lo llama la gestión de datos | Trust Erosion (el lector humano) | ¿Quién lo decidió? (el lector agente) |
|---|---|---|---|
| Ambigüedad concepto-entidad | Glosario de negocio, metadatos, datos maestros | Falso consenso semántico · La tabla no es el concepto · Tu glosario no es semántica | El agente que elige la tabla por su nombre |
| Datasets canónicos, con el agente “dirigido estructuralmente a ellos primero” | Sistema de registro, fuente confiable | El número sin perímetro | La autoridad como regla de elegibilidad, no como señal de ranking |
| Desactualización: la precisión cayó de ~95% a ~65% en un mes | Vigencia de los metadatos | – | – |
| Modelos deprecados en el grafo de linaje | Datos ROT, retiro | – | Por qué nadie borra, y por qué la tabla vieja sigue compitiendo |
| Definiciones de métricas generadas por un LLM que “codificaban justamente las ambigüedades que tratábamos de eliminar” | Custodia de metadatos (stewardship) | La métrica como espejo, no como ventana | Una AI documenta, otra AI elige |
| Un pie de página de procedencia: nivel de la fuente, frescura, dueño | Linaje, dueño del dato | El número sin perímetro | Cuando el agente se equivoca, quién responde |
| Contexto de negocio: un grafo de conocimiento con documentos, roadmaps y bitácoras de decisiones | Metadatos de negocio | – | ¿Quién lo decidió?: la serie entera |
| Recoger cada corrección de los usuarios y convertirla en un arreglo para el dueño del dominio | Gestión de incidentes, calidad de datos | La disciplina de la desconfianza | Cuando el agente se equivoca, quién responde |
Fijate en las bitácoras de decisiones. Anthropic tuvo que escribir quién decidió qué, para que el agente lo pudiera leer. Hugo no sabe nada de tu negocio porque, en la mayoría de las empresas, esas decisiones nunca se escribieron en ningún lado.
Mirá la última fila, porque es la que resuelve mi problema con Hugo. Anthropic se quedó con el mejor lector. Un agente programado revisa cada pocas horas los canales donde los usuarios corrigen respuestas, redacta un arreglo de una línea a la documentación y abre un pull request asignado a la persona dueña de ese dominio. Pero mirá de cerca, y esa persona ya no es opcional. Todo el circuito de correcciones arranca cuando alguien en ese canal lee una respuesta bien formateada y no se la cree. Al 95%, es una respuesta de cada veinte, y le cae a alguien que preguntó justamente porque no quería verificar. Anthropic no reemplazó al mejor lector. Hizo que el sistema dependa de uno.
Significado y verdad
El marco de Hawker para todo el keynote fueron dos palabras. Una AI confiable necesita significado (meaning) y verdad (truth), y en su opinión la industria está comprando lo primero y olvidándose de lo segundo. Significado es qué es un cliente: ¿“cliente activo” es alguien que entró al sistema, o alguien con contrato vigente? Verdad es cuáles clientes son reales: ¿estos 200 registros son 200 empresas, o son 80 con nombres nuevos? Necesitás las dos. Un slide lo dijo sin rodeos: “Significado sin verdad es confusión.”
La cuarta sesión del día, Your AI Agent Is Confidently Wrong About Your Biggest Customer (tu agente de AI está equivocado, y muy seguro, sobre tu cliente más grande), lo convirtió en un caso. Le piden a un agente un resumen de una cuenta clave. Consulta el CRM, las grabaciones de llamadas, la plataforma de customer success, y vuelve con una respuesta segura y bien formateada que hubiera costado una renovación. No pudo darse cuenta de que cuatro empresas con nombres distintos eran una sola familia corporativa, ni de que siete registros del CRM eran cuatro clientes.
Estoy de acuerdo con la división. No estoy de acuerdo en dos cosas: la palabra verdad, y el orden. Como lo voy a etiquetar, prefiero decir por qué antes que asentir.
Mi primer post de Trust Erosion tenía la imagen espejo. Un distribuidor de químicos en Costa Rica, unos 1.800 registros en la base de clientes, y apenas 200 de ellos eran clientes activos. Cada venta en esa base había ocurrido y estaba bien registrada. Según la división de Hawker, los registros eran verdaderos. El conteo igual estaba mal, porque nadie había decidido qué era un cliente. Así que yo le agregaría la otra mitad a su slide: verdad sin significado es una lista perfectamente limpia de cosas que nadie definió.
Después, el orden. El camino de construcción de Hawker va de la resolución de identidad a los conceptos de negocio compartidos. Yo iría al revés, y el caso de la cuarta sesión es la razón. “Cuatro empresas con nombres distintos son un solo cliente”: ¿es un hecho sobre los registros, o una decisión sobre la definición? Depende de si tu cliente es la entidad legal que firma la factura o la familia corporativa que negocia la renovación. Si emparejás esos registros antes de decidir, el algoritmo decide por vos. No podés resolver la identidad hasta haber resuelto el significado. En el distribuidor, la definición de cliente activo vino primero, y nadie había deduplicado nada todavía.
Por eso yo le llamaría identidad a la segunda capa, no verdad. El propio capítulo de datos maestros de DAMA advierte que “golden record” es un término engañoso y prefiere fuente confiable (trusted source): una fuente en la que decidiste confiar, no una que contiene la verdad. La verdad suena a algo que se descubre. La identidad es algo que alguien decide, y escribe, y por lo que responde.
(Coincidimos en las capas y en su punto principal: sin identidad, el agente falla. No coincidimos en el nombre de una y en cuál se construye primero.)
La lección: primero el significado, después la identidad, y las dos son decisiones antes de ser datos.
Lo que creo que falta
El artículo es honesto sobre su contexto, así que esto no es una crítica a lo que construyeron. Es una lista de lo que ese contexto les dio y el tuyo probablemente no.
Tienen un solo repositorio. Casi todo su código de datos (modelos, capa semántica, documentación y dashboards) vive junto, y alrededor del 90% de los cambios al modelo de datos actualizan la documentación del agente en el mismo pull request. Tu lógica probablemente vive en un ERP que no es tuyo y en código que nadie lee hace años. Acabo de ver a un agente construir un modelo entero sobre la tabla equivocada, y la razón fue el nombre de la tabla. Esa historia tiene su propio post.
Tienen un mandato. Su gobierno, en sus palabras, “solo se sostiene si los modelos canónicos y las definiciones de métricas se imponen con herramientas (el agente se dirige estructuralmente a ellos primero), con CI y por mandato”. Alguien en Anthropic podía decir: esta es la tabla, usala. En la mayoría de las empresas con las que trabajo, nadie tiene la autoridad para decir eso, o nadie quiere gastarla.
Deprecan, pero el artículo nunca dice que borren. Su grafo de linaje le dice al agente qué modelos están deprecados. Eso está bien, y es más de lo que hacen la mayoría de las empresas. Pero una tabla deprecada sigue siendo una tabla. Sigue respondiendo a su nombre, y el próximo agente, o el próximo analista con un notebook, la puede encontrar. Marcar algo como viejo es una decisión que cualquiera puede tomar. Borrarlo necesita un dueño.
Mencionan los controles de acceso y la privacidad de datos entre las preguntas de diseño, y ahí se quedan. Quedan abiertas dos preguntas que el próximo agente va a traer: qué nunca se le debió permitir leer, y qué pasa cuando un documento que lee le da una orden.
Y está el vocabulario. Reconstruyeron datos maestros, gestión de metadatos y calidad de datos, y los llamaron datasets canónicos, documentos de referencia y evals. Para Anthropic, está bien. Para tu gerente financiero puede salir caro: al leerlo, quizás no reconozca que el presupuesto de gobierno de datos que sigue posponiendo es su presupuesto de preparación para la AI.
Alguien lo decidió
Esto es lo que el artículo demuestra, creo, sin proponérselo. Los agentes de Anthropic llegan al 95% porque alguien decidió: qué tabla es la canónica, quién es dueño de cada definición, adónde va una corrección, qué lee primero el agente. Esas decisiones no las tomó el modelo. Las tomaron personas, y las escribieron.
Ahora hacé la misma pregunta sobre tus datos. ¿Quién decidió que la tabla vieja de ventas se quedara? ¿Quién escribió la descripción que lee el agente? ¿Quién aprobó lo que puede ver? ¿Quién responde cuando se equivoca?
En la mayoría de las empresas, la respuesta a las cuatro es la misma. Nadie.
Esa es la próxima serie. Se llama ¿Quién lo decidió?: diez posts en cuatro partes. Los datos ROT contra los que compite el agente, decidir qué guardar, lo que lee el modelo, y quién responde. La nube y la AI hicieron barato crear, copiar y guardar datos. No hicieron más barato decidir.
Trust Erosion preguntaba quién lee el número. Esta pregunta quién decidió lo que lee el agente.
Antes de apuntar un agente a tus datos
Cinco preguntas. Si no podés contestar una, por ahí se empieza.
- Para el dominio donde querés al agente, ¿cuántos datasets canónicos tenés, y quién los declaró canónicos?
- Para cada métrica que va a usar el agente, ¿el dueño es una persona o “el equipo”?
- ¿Qué parte de las respuestas del agente pasan por tu modelo semántico y no por tablas crudas?
- Cuando alguien corrige al agente, ¿adónde va esa corrección? Si la respuesta es “al historial del chat”, no va a ningún lado.
- ¿Quién en tu empresa puede mandar que la tabla canónica sea la que usan todos?
El consejo de Anthropic para arrancar de cero es corto: un puñado de datasets canónicos, unas cuantas docenas de pruebas y una capa delgada de documentación que el agente lee primero. Nada de eso es un problema del modelo.
Deja una respuesta