La semana pasada dije que el lector cambió. Antes de llegar al lector nuevo, quiero mirar lo que lee: la masa que se acumula alrededor de los datos buenos, y que nadie decidió guardar.
2008, Ciudad de México
En 2008 pasé dos semanas en Ciudad de México construyendo una prueba de concepto para el Nacional Monte de Piedad, la institución que presta dinero con garantía de joyas, relojes y artículos del hogar en México desde 1775. Microsoft la cofinanció. El objetivo era mostrar dos cosas que traía SQL Server 2008: minería de datos y los nuevos tipos geoespaciales. Monte de Piedad puso la pregunta de negocio. Planeaban abrir 80 sucursales en tres años, y querían saber dónde.
La pregunta suena simple. No lo es. Es un problema clásico de análisis espacial, la disciplina que estudia cómo la ubicación moldea el comportamiento, y en retail tiene nombre propio: site selection, la selección de sitios. De dónde va a sacar sus clientes una sucursal nueva depende de qué tan grande es, de qué tan lejos está dispuesta a viajar la gente y de quién ya está abierto en la misma calle. La geografía del comercio contestó esa pregunta hace casi un siglo pidiéndole prestado a la física: una tienda atrae clientes como una masa atrae a otra. Cuanto más grande la tienda, más fuerte la atracción. Cuanto más lejos el cliente, más débil. Yo no era geógrafo del comercio. Antes de esas dos semanas en México pasé unos seis meses leyendo esa literatura, tratando de entender por qué atraen las tiendas, cómo se apaga la atracción con la distancia y por qué los competidores se juntan en la misma calle en vez de repartirse.
Con eso en la mano, construimos una base de datos: la ubicación de todas las sucursales del país, las de Monte de Piedad y las de la competencia, y el desempeño comercial de las sucursales propias. Después llegaron los puntos de interés alrededor de cada una. Encima escribimos vistas que hacían los cálculos geoespaciales, y esas vistas entrenaron los modelos de minería de datos. Lo que salía del otro lado era un mapa de Virtual Earth. Puntos rojos para Monte de Piedad, puntos azules para la competencia. Alrededor de cada sucursal el modelo dibujaba un área de influencia: la zona de donde una sucursal saca sus clientes, más ancha cuanto más grande la sucursal, más débil cuanto más lejos vive el cliente. Donde los puntos azules se juntaban sin un punto rojo cerca, teníamos una zona candidata. Los competidores agrupados atraen más juntos de lo que atraerían por separado, y Monte de Piedad no estaba ahí para llevarse nada de esa atracción. Peor: le estaba dejando ese mercado a la competencia.
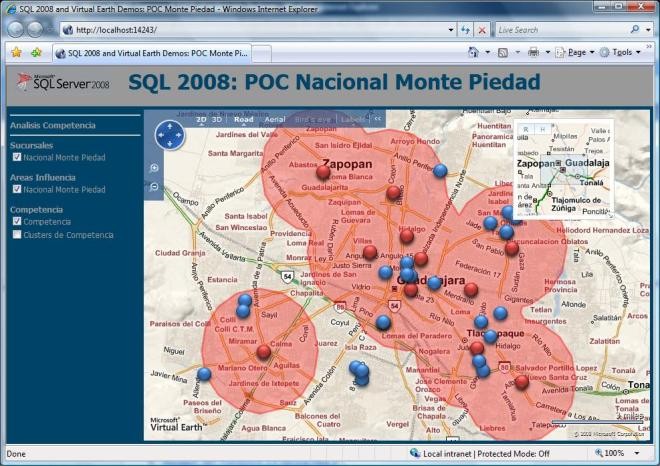
Una de las vistas del estudio nacional: Guadalajara. Rojo, Monte de Piedad; azul, la competencia. El grupo azul abajo al centro es una zona candidata fuerte.
El modelo no decidía nada. Dibujaba un mapa para la gente que conocía el negocio. Mi parte terminó con la POC; Microsoft la convirtió en videos y demos, y nunca supe dónde abrió finalmente Monte de Piedad sus sucursales, ni con qué modelo.
Lo que me quedó fue la gravedad. Fue mi primer encuentro con un modelo gravitacional fuera de la física: la ecuación de Newton, escrita para planetas, con metros cuadrados donde va la masa y kilómetros donde va la distancia. Y describía una calle de Guadalajara lo bastante bien como para discutir dónde poner plata de verdad. No perfecto. Lo bastante bien. Desde entonces creo, y no tengo cómo probarlo, que la gravedad es más universal que la física: lo que se acumula atrae, y lo que está lejos atrae menos. Guardé la captura de pantalla y di charlas sobre el SQL detrás del mapa. Y con toda esa convicción, en mi cabeza era una herramienta de negocio. Nunca se me ocurrió apuntarla a mi propio trabajo, a las tablas detrás del mapa, que tenían su propia gravedad.
Tenía la gravedad en las manos, y no vi que los datos también tienen masa.
Alguien más lo vio
Leí “Data Gravity”, de Dave McCrory, años después de que lo publicara en su blog, en diciembre de 2010. Asentí, y lo olvidé. Nunca usé el término con un cliente.
Este año un amigo lo trajo de vuelta. El artículo de Adrian Miranda Cordero “Control de costos en la nube: cuando la elasticidad se convierte en el problema” pone la gravedad de los datos en el primer lugar de su lista de patrones detrás de facturas de nube que crecen mientras el negocio no. Esta vez la idea pegó, porque yo tenía algo con qué contrastarla: los datos ROT, los datos Redundantes, Obsoletos o Triviales (Redundant, Obsolete, Trivial). La tensión entre esas dos ideas, la gravedad de los datos y el ROT, es lo que encendió este post. Cada una, sola, explicaba la mitad de lo que veo en las plataformas de datos de hoy. Necesitaba ponerlas a tirar una contra la otra.
La definición de McCrory, en sus palabras:
“Considerá los datos como si fueran un planeta u otro objeto con masa suficiente. A medida que los datos se acumulan (ganan masa) es más probable que servicios y aplicaciones adicionales se sientan atraídos por esos datos.” (traducción mía)
McCrory nos pidió tratar los datos como un planeta, así que tomémosle la palabra y usemos a Newton:
g = G · M / r²
g es el tirón que sentís, M es la masa (digamos gigabytes), r es la distancia. A G la dejo en paz. Es una constante, y en el momento en que empezás a mapear constantes físicas a TI, una metáfora útil se convierte en pseudociencia.
Fijate en lo que está en la ecuación, y en lo que no. No hay V (valor). Un petabyte de snapshots duplicados tira de tu arquitectura exactamente igual que un petabyte de saldos del mayor general o de transacciones. Y la masa se suma: dos cuerpos cerca tiran como uno solo. Guardate eso. Vuelve más adelante.
Quiero hacer la comparación explícita, porque atraviesa toda esta serie. En 2008 dibujamos el mapa de una ciudad. Acá dibujamos el mapa de tu plataforma de datos. La ecuación no cambia. Lo que mide cada letra, sí:
| Selección de sitios, 2008 | Tu plataforma de datos | |
|---|---|---|
| Lo que atrae | Una sucursal | Una tabla, un modelo, un dataset |
| Masa (M) | Metros cuadrados | Gigabytes |
| A quién atrae | Un cliente | Un usuario, un reporte, un pipeline |
| Distancia (r) | Kilómetros de la casa a la sucursal | El esfuerzo para llegar al dato |
Ahora imaginá tu plataforma de datos como nos pidió McCrory, como un sistema solar. El lakehouse es un gigante gaseoso, y el warehouse de al lado es otro. Alrededor orbitan los data marts, planetas más chicos con sus propias lunas. Y por todos lados hay asteroides: los archivos de Excel en la laptop de cada uno. Cada uno tira con su masa.
Acá tiran dos cosas distintas. La masa tira de la arquitectura: servicios, pipelines, backups, costo. No le importa el valor. Lo que atrae a un usuario es otra cosa, y ya vamos a llegar.
Por masa, el lakehouse debería ganar siempre. No gana. El Excel en mi máquina no pesa casi nada, pero está ahí: doble clic y entré. El lakehouse es enorme, y está lejos. Tengo que encontrar el workspace correcto, pedir acceso, esperar a que alguien lo apruebe, averiguar cuál de cuarenta tablas es la buena, y después aprender qué significan las columnas. Eso es r. No kilómetros, no milisegundos. Esfuerzo.
Y en Newton r va al cuadrado. No voy a defender el exponente para el esfuerzo, pero la forma es correcta: la distancia no solo debilita la atracción, la aplasta. Así es como el Excel de mi laptop me atrae más que un lakehouse con cien mil veces sus datos. Y fijate en lo que nadie revisa cuando gana el planeta más cercano: si el Excel sigue siendo cierto. Muchas veces es la exportación del mes pasado.
La nube no borra. Te hace descuento.
En abril de 2011, cuatro meses después de “Data Gravity”, McCrory publicó “Defying Data Gravity”, diez estrategias para vivir con datos pesados, desde caché y replicación hasta compresión. Cada una mueve los datos, los copia, los esconde o acerca la aplicación. McCrory nunca lo dice así, pero la mayoría juega con r. Ninguna borra nada. No es una crítica: él resolvía latencia, no gobierno. Un año después hasta le puso nombre al incentivo que lo empeoraba, artificial data gravity, la gravedad artificial: subir datos a S3 y a Azure era gratis. Meter datos se abarató a propósito. Decidir qué hacer con ellos, no.
Adrian Miranda lee la misma gravedad desde el costo. La data, escribe, “gravita y acumula”, una propiedad que las aplicaciones no tienen: “Un servidor de aplicación puede reiniciarse tranquilamente cada noche”. Una plataforma de datos no. Su storage sprawl es una lista que reconocí enseguida: data histórica online por defecto sin política de retención, logs de ejecución guardados indefinidamente, backups redundantes. Eso es ROT, la O y la R, descrito sin el nombre. Una de sus preguntas para un director de tecnología es el puente a este post: “¿Cuánta data histórica está online que no se ha consultado en los últimos seis meses?” Él pone el costo. Yo quiero agregar el riesgo.
Cada fila que guardás es algo que tenés que proteger, algo por lo que un auditor te puede preguntar, y algo que se puede filtrar. El nombre, la cédula y el teléfono de un cliente son valor y pasivo en el mismo registro. Casi todas las leyes de privacidad dicen lo mismo con otras palabras: guardá los datos personales solo mientras siga vivo el propósito que justificó recolectarlos. Cuando el dato es relevante, el valor paga el riesgo. Cuando es ROT, cargás con el riesgo y nadie cobra el valor. Esa parte nunca aparece en la factura de la nube.
Hay otro costo que tampoco aparece en la factura de la nube, y es r. Cada tabla ROT en el lakehouse es un lugar más donde alguien tiene que buscar, un “¿cuál de estas es la buena?” más, un mensaje más al colega que capaz sabe. El ROT no solo pesa. Aleja los datos buenos. Tu proveedor de nube no te cobra ese esfuerzo. Lo pagás en planilla, por hora, a gente que contrataste para usar los datos, no para salir a buscarlos.
Quince años después de la lista de McCrory, las herramientas siguen en el mismo lugar. El almacenamiento en la nube tiene reglas de ciclo de vida que pueden borrar, y en los proyectos en los que he trabajado casi nunca se activan para datos curados.
Así que casi siempre la nube no borra. Te hace descuento. De hot a cool, de cool a archive, una línea más chica en la factura, y los datos se quedan exactamente donde estaban en tu arquitectura, tirando todavía.
Y hay un problema más de fondo. El almacenamiento decide por archivo y por fecha. El ROT vive en filas y en significados.
El nombre
Si la nube no borra, ¿quién borra? Tiene que ser alguien que sepa leer filas y significados, no archivos y fechas. Pero antes de que alguien lo pueda buscar, lo que busca necesita un nombre.
Encontré el término este año, estudiando para el CDMP. El DMBOK2 (el Data Management Body of Knowledge de DAMA, 2.ª edición) lo usa exactamente una vez, en el capítulo 1, entre las implicaciones del ciclo de vida de los datos (§2.5.9):
“Los esfuerzos de gestión de datos deben enfocarse en los datos más críticos: las organizaciones producen muchos datos, y una gran parte nunca se usa. No es posible gestionar cada dato. La gestión del ciclo de vida requiere enfocarse en los datos más críticos de la organización y minimizar el ROT de datos (datos Redundantes, Obsoletos, Triviales) (Aiken, 2014).” (traducción mía)
Eso es todo. (El DMBOK se lo atribuye a Aiken; yo cito al DMBOK, no a él.) Tres oraciones me alcanzaron para engancharme. Nadie parece saber quién acuñó el término. Anda dando vueltas por lo menos desde principios de los 2000, y está en su casa en la gestión documental (records management) y el gobierno de la información, dos mundos con los que BI casi no habla. Así fue como pasé 25 años en BI sin escucharlo.
De vuelta en el DMBOK, el capítulo 9 (Gestión de documentos y contenido) tiene la psicología, sin la sigla. Una de sus razones por las que las organizaciones no eliminan la información que no agrega valor: “el costo percibido de tomar una decisión y de eliminar registros físicos y electrónicos” (traducción mía). El costo de tomar una decisión. Esa es la bajada de esta serie, sentada en el DMBOK.
Lo curioso es que yo ya había descrito el ROT antes de saber su nombre. En el Halloween de 2017 escribí un post para el blog de Primus Data llamado “La bodega de datos zombis”. La bodega zombi se mueve, con cargas diarias o semanales, pero el movimiento es automático: “El Zombi-DW es un autómata que no puede explicar porque se hacen ciertos procesos o tareas, ni cuál es el valor de la información almacenada”. Y como todo zombi, se alimenta de los suyos: “queman valiosos recursos” en mantenimiento y soporte de TI. Ese es el costo de Adrian, nueve años antes. En 2017 le dije zombi. En 2026 descubrí que ya tenía nombre. Menos cinematográfico que el mío, pero tiene su lógica: en inglés rot es pudrirse, y los zombis se pudren.
El mismo post tenía una frase que vi cumplirse otra vez hace como un año, en un cliente: “aun teniendo usuarios este modelo sea un zombi, ya que los clientes del almacén de datos lo usan como autómatas”. En un proyecto para una empresa grande yo era responsable de un modelo tabular, y revisando la adopción dejé el filtro abierto para ver todos los demás. En dos de ellos, el usuario más activo era el desarrollador, corriendo pruebas de regresión semanales que comparaban las métricas de producción contra la versión nueva. Después de ocho años en producción, la única “adopción” que tenían esos modelos era la prueba del propio desarrollador de que seguían vivos. El zombi generaba su propio uso. La tecnología había cambiado por completo desde 2017. El comportamiento, no.
De vuelta en México: Newton no alcanzaba
De vuelta al mapa. Nuestra primera iteración en México era exactamente la fórmula de arriba, con M en metros cuadrados de sucursal. No alcanzó, por dos razones.
La primera es la aglomeración. Las casas de empeño se agrupan. Cinco en la misma avenida no se comportan como cinco masas chicas; los clientes leen la calle como el lugar donde uno va a empeñar algo, y el grupo atrae más que las cinco sumadas. Ese grupo azul abajo en el mapa de Guadalajara es exactamente eso.
¿Te acordás de que te pedí guardar lo de “la masa se suma”? Acá es donde Newton se queda corto, en México y en datos. Los datos también se aglomeran, pero lo que atrae son cosas distintas que van juntas. Clientes, compras y productos, cada uno por su lado, atraen a muy pocos usuarios. Juntalos, una compra que apunta a un cliente y a un producto, y responden preguntas que ninguno podía responder solo. La atracción salta. En una corporación, los clientes de una empresa atraen a pocos usuarios. Los clientes de todas las empresas, integrados en plata, atraen a muchos más.
Ahora agrupá customer, customer_v2 y customer_old. Pueden pesar exactamente lo mismo que el conjunto integrado. No atraen igual. Cinco casas de empeño en una avenida son cinco ofertas reales para comparar. Tres copias de la tabla de clientes son una oferta y dos ecos.
Pensá en un food court. Funciona porque es aglomeración bien hecha: tacos, sushi, pizza y un casado (plato típico costarricence), ofertas distintas que atraen más juntas que las cuatro sumadas. Ahora pensá en uno donde diez mostradores venden el mismo menú. Uno todavía tiene los precios del año pasado, otro tiene un plato tachado con cinta, y nadie te dice cuál cocina sigue cocinando. No tenés diez opciones. Tenés una, y el trabajo de averiguar en qué fila usa.
El ROT le suma peso a los datos buenos, y ese peso lo pagás vos. No le suma nada a lo que esos datos te pueden decir.
La segunda razón: el tamaño solo no explicaba la atracción. Dos sucursales del mismo tamaño no atraían igual. Así que agregamos lo que había alrededor de cada una (paradas de bus, escuelas, parques, iglesias) y dejamos que un árbol de decisión nos dijera cuáles importaban. La atracción resultó tener varios atributos, y fueron los datos, no nuestra intuición, los que los eligieron.
Los modelos de datos también tienen atributos, pero nadie les ha corrido ese árbol de decisión, que yo sepa. Así que la lista de abajo sale de la única fuente que tengo: años de ver a la gente adoptar un modelo e ignorar el de al lado. Es mía, de campo, no de un paper. Tomala como un primer intento:
| Atributo | Qué significa en un modelo de datos |
|---|---|
| Nombres en lenguaje de negocio | “Ventas Netas”, no amt_net_lcl. El usuario reconoce lo que está mirando. |
| Fácil de navegar | Pocas tablas, relaciones claras. Encontrás lo que necesitás sin mapa. |
| Metadata que explica | Descripciones que te dicen qué incluye una medida y qué deja afuera. |
| Calidad | Los números están bien, y cuadran con la contabilidad. |
| Esconde la complejidad técnica | Llaves subrogadas, columnas de staging y banderas de carga quedan fuera de la vista. |
| Relevancia (señal, no ruido) | Responde una pregunta que el negocio se está haciendo hoy. |
Esa es la otra cosa que te prometí: lo que atrae a un usuario hacia un modelo no es su tamaño. Son estos seis. Ahora hacete la pregunta incómoda: ¿una copia vieja, el modelo que nadie retiró, puede atraer igual? Recorré la lista. Los nombres: sí, una copia los hereda. Fácil de navegar: sí, y muchas veces el modelo viejo es el más simple. La metadata: sí, las descripciones también se copiaron, o se escribieron cuando eran ciertas. La calidad, como la revisa casi todo el mundo: sí. Los datos estuvieron bien una vez, siguen estándolo, y siguen cuadrando con la contabilidad de donde salieron. La única dimensión de calidad que falla es la vigencia (timeliness), y nadie revisa la vigencia cuando elige un modelo. Lo que se murió es el contexto. Esconder la complejidad: sí, la edad no tiene nada que ver. Relevancia: no.
El ROT puede ganar en cinco de seis. La que no puede fingir es la relevancia: lo obsoleto y lo trivial no la tienen, y lo redundante la tiene prestada del original. Eso es solo la definición. Lo que importa es que los otros cinco, los que se ven, no te dicen cuál es cuál. Y la relevancia no aparece en el esquema.
Materia oscura: peso sin luz
Los astrónomos se toparon con este problema también, a una escala mucho más grande. Las galaxias giran demasiado rápido para la masa que se ve. Las estrellas de los bordes orbitan como si algo las sostuviera, y con solo lo que brilla deberían salir disparadas. Newton, contando solo la masa visible, no cuadra. Entonces tiene que haber masa que nadie ve: la materia oscura. Atrae como cualquier otra masa, pero no emite, ni absorbe, ni refleja luz. (Los más académicos van a reconocer a Fritz Zwicky, que la llamó dunkle Materie en 1933, y a Vera Rubin, cuyas curvas de rotación de galaxias en los años 70 la hicieron difícil de ignorar.)
Eso es el ROT. Cuenta en la gravedad. Mantiene en órbita backups, pipelines y las pruebas de regresión de un desarrollador, y aparece en la factura. Tu plataforma se comporta como si pesara mucho más que los datos que de verdad usás, y esa es la pista de que está ahí. Pero no da luz, y por luz quiero decir información que sirve para decidir. La atracción es lo que te hace caminar hasta ahí. La luz es lo que encontrás cuando llegás. El ROT puede tomar prestada la atracción, cinco atributos de seis. Cuando llegás, no tiene nada que mostrarte. Igual, no tener luz es un veredicto sobre un propósito: no todo lo oscuro es ROT, y eso da para otro post.
La lección: el ROT tiene masa y no tiene luz. La masa explica el costo, y la exposición. El otro riesgo es lo que pasa cuando atrae igual: alguien, o algo, lo elige, y decide a oscuras.
Dibujar el mapa de una tabla de clientes
La relevancia no aparece en el esquema. Hay que medirla.
Hace poco trabajé en un modelo de cuentas por cobrar para un cliente. El plan era el obvio: usar la misma dimensión de clientes que ya usaban todos los demás modelos. Una dimensión conformada, en el lenguaje de Kimball. Y acá hay una mala lectura que veo todo el tiempo: la gente entiende conformada como los mismos datos. No es eso. Conformada quiere decir los mismos nombres de columna, los mismos significados de atributo y los mismos valores de dominio, para que un cliente se vea igual en cada modelo que lo toca. Las filas pueden ser idénticas a las de la dimensión completa, o un subconjunto (para los puristas, esa es la prueba de conformidad de Kimball, y acepta las dos). El default es idéntica. Nadie pregunta.
Después perfilé la tabla, y no le encontraba sentido. La factura electrónica era obligatoria desde hacía rato. ¿Por qué una tabla de clientes estaba tan sucia? Bloques enteros de cédulas raras y nombres extraños.
Me costó verlo. Los datos no estaban sucios. Estaban viejos. Un poco de contexto, por si en tu país no existe esto: en Costa Rica la factura electrónica va a Hacienda, que la valida, y tiene que nombrar a un cliente que Hacienda pueda identificar. Antes de que fuera obligatoria, el sistema viejo guardaba el nombre que el cliente daba en la caja, con un número de cédula en el que nadie podía confiar. Después, un cliente era alguien que Hacienda podía encontrar. El significado de “cliente” cambió, y nadie volvió a marcar los registros del régimen viejo.
La semana pasada escribí que el significado va primero. En aquel distribuidor, nadie había decidido qué era un cliente. Acá alguien sí lo había decidido, y después el significado se movió, y los registros viejos se quedaron donde estaban. Decidir una vez no alcanza. Alguien tiene que volver.
Cuando lo medí, más o menos dos de cada tres clientes de esa tabla eran registros ROT. Casi todo el resto eran registros buenos que no tenían nada que ver con cuentas por cobrar: clientes reales, cédulas válidas, sin saldos, sin cobros. Los clientes que de verdad le importaban a cobros eran alrededor del 4% de la tabla.
Esos dos tercios no se pudrieron con la edad. Se pudrieron en bloque, el día que cambiaron las reglas. Son obsoletos por cambio de régimen, no por fecha. Ninguna regla basada en fechas de creación los iba a encontrar nunca, porque no son archivos. Son filas en una tabla viva.
“Entonces borralos.” No. Las facturas históricas apuntan a esos clientes. Ahí está la gravedad: facturas correctas agarradas de clientes muertos. Borrás el cliente y rompés la factura. Y el DMBOK advierte contra desechar demasiado pronto con la misma claridad que contra guardar demasiado tiempo: algo de lo que parece ROT es el registro que vas a necesitar el día después de una auditoría.
El riesgo también era real, aunque nunca apareciera en una factura. El default mandaba los datos personales de toda la tabla, nombres y cédulas incluidos, a cada modelo, para un propósito que necesitaba el 4%. Nadie había aprobado esa exposición. A nadie le habían preguntado.
Así que dibujé el mapa. Si lo vas a correr sobre tus datos el lunes, acordate: no es una herramienta para borrar. Es para decidir.
Tiene dos ejes, y debería funcionar con cualquier entidad que tenga un proceso de negocio detrás, no solo con clientes.
El primer eje es la actividad: el último evento de negocio del proceso, dentro de una ventana que elegís vos. La antigüedad se mide desde la última actividad, nunca desde la creación. Así es como aparece el cambio de régimen: los registros viejos se crearon en mil días distintos, así que la fecha de creación no los encuentra. Los que se pudrieron se quedaron quietos cuando cambiaron las reglas. Los que siguieron moviéndose se quedan, con una etiqueta. Las excepciones se escriben explícitas: lo legal o vital se queda, tenga la actividad que tenga. En el modelo de cuentas por cobrar, las cuentas en cobro judicial tuvieron una ventana mucho más larga que todo lo demás.
Una regla antes de medir la actividad, cortesía del zombi con un solo usuario: no contés la actividad que generan tus propios sistemas. En un modelo, son las pruebas de regresión del desarrollador y la cuenta que lo refresca. En un cliente, puede hacer mucho más ruido. En 2008, en un retailer en Brasil, un robot de monitoreo entraba al sitio web y hacía un pedido cada cinco minutos, con factura incluida, para levantar una alerta si el sitio o la facturación se caían. Por cantidad de facturas, probablemente era su cliente más fiel. Actividad quiere decir que el negocio hizo algo.
El segundo eje es la verificación, en tres estados: verificado por una autoridad externa (para nosotros, Hacienda), formato válido pero sin verificar, e inválido. En la mayoría de las entidades, la columna de verificación necesita otra autoridad; a veces es tu propio dato maestro.
(Para la gente de calidad de datos: inválido falla la validez, verificado pasa la exactitud, y la vigencia es trabajo del eje de actividad.)
| Verificado | Formato válido, sin verificar | Inválido | |
|---|---|---|---|
| Con actividad | Se queda. Etiqueta verificado | Se queda. Etiqueta sin verificar | Se queda. Etiqueta inválido |
| Sin actividad | Registro histórico seudonimizado | Registro histórico seudonimizado | Registro histórico seudonimizado |
Fijate en lo que decide cada eje. La actividad decide si el registro se queda identificado. La verificación no decide nada: se vuelve metadata que el usuario puede ver. Es tentador filtrar las cédulas inválidas, o mandarlas a cuarentena. No lo hagás. Un cliente activo con una cédula inválida no es ruido. Es una señal: alguien tiene que arreglar ese registro, y cobros quiere saberlo antes de llamar. Ese es el atributo de “metadata que explica” de la tabla de arriba, haciendo su trabajo.
Con el mapa sobre la mesa, hubo dos cortes. El primero, en la dimensión de clientes completa, la que usan todos los modelos: los clientes sin actividad pasaron a ser registros históricos seudonimizados. Las facturas siguen apuntando a alguien; ni el nombre ni la cédula de nadie viajan ya con ellas. (Seudonimizados, no anonimizados: la cédula se transforma con un hash y un salt que guardamos nosotros, así que se podría revertir. No lo hacemos.) Ese corte no necesitó mi argumento. La ley de protección de datos ya lo pedía, y los registros de antes de la factura electrónica no eran el activo de nadie. El segundo, solo para cuentas por cobrar: una dimensión conformada con la completa, mismos nombres, mismos significados, mismos valores, con solo los clientes que tienen crédito y algo que cobrar. Un cliente de contado es real y está vivo. Para cuentas por cobrar, es trivial. No se borró nada. Cómo lo construimos da para su propio post más adelante en la serie; el principio cabe en una línea: la masa se queda, la exposición se va.
El dueño de producto firmó el segundo. Por las razones equivocadas. Yo argumentaba gobierno; el negocio escuchó desempeño. Pasar de la tabla completa a más o menos un cliente de cada veinticinco cambia cómo se comporta un modelo, sobre todo cuando la dimensión de clientes carga decenas, incluso cientos, de atributos. El modelo se volvió más rápido, y eso fue lo que lo vendió.
Lo acepto. Una decisión correcta por la razón equivocada sigue siendo una decisión. Pero pensá lo que significa: si el modelo hubiera sido lo bastante rápido, nadie habría firmado nada, y cuentas por cobrar seguiría cargando la tabla entera para cobrarle al 4%.
La lección: si algo es ROT lo decide la relevancia, no la calidad. Y alguien lo tiene que decidir.
Nadie dibujó el mapa
En 2008 nunca supe quién decidió dónde iban las 80 sucursales. Pero había un mapa, y la gente que conocía el negocio lo tenía enfrente.
Nadie dibujó nunca el mapa de esa tabla de clientes. Dos de cada tres clientes viajaron a cada modelo durante años, y no porque alguien decidiera que tenían que viajar. Nadie había puesto los puntos en un mapa. Cuando alguien por fin lo hizo, las decisiones se tomaron: una porque la ley lo exigía, la otra por una razón que yo no habría elegido.
Entonces, ¿cuánta de la gravedad de tus datos es ROT? ¿Y quién lo decidió?
La próxima vez volvemos a r, y a quién elige cuando el que elige no es una persona.
Este es el primero de diez posts de ¿Quién lo decidió? La nube y la AI abarataron crear, copiar y guardar datos. No abarataron decidir.
Deja una respuesta